2 Minute
Imaginează-ți că intri în direct și, fără mare tam-tam, vocea și imaginea ta devin parte dintr-un set de antrenament pentru următoarea generație de inteligență artificială a Amazon. Exact această schimbare a anunțat-o Twitch: conținutul streamurilor va putea fi utilizat pentru a antrena modelele Amazon, cu excepția cazului în care creatorii renunță.
Controversele privind confidențialitatea datelor brute de antrenament nu mai sunt doar teoretice. Dezvoltatorii și echipele juridice s-au confruntat ani de zile din cauza surselor din care învață modelele mari. Unele companii evită disputa folosind doar materialele de pe propriile platforme. Meta, de exemplu, poate folosi pagini publice de pe Facebook și Instagram. Profilurile private, însă, rămân inaccesibile, cel puțin în principiu.
Ceea ce diferențiază Twitch este amploarea și intimitatea. Streamurile sunt lungi, multimodale și dezordonate: ore de voce, cameră frontală, chat în direct, gameplay și momente spontane pe care nu le vei găsi în arhive curate. Pentru cercetătorii în inteligență artificială, această dezordine este o mină de aur pentru a învăța modelele să vorbească, să reacționeze și să se comporte mai mult ca oameni reali. Pentru creatori, pare că cineva răscolește printr-un pod digital.
Transmisiunile tale anterioare ar putea învăța următoarea generație de AI cum să vorbească, să arate și să reacționeze.
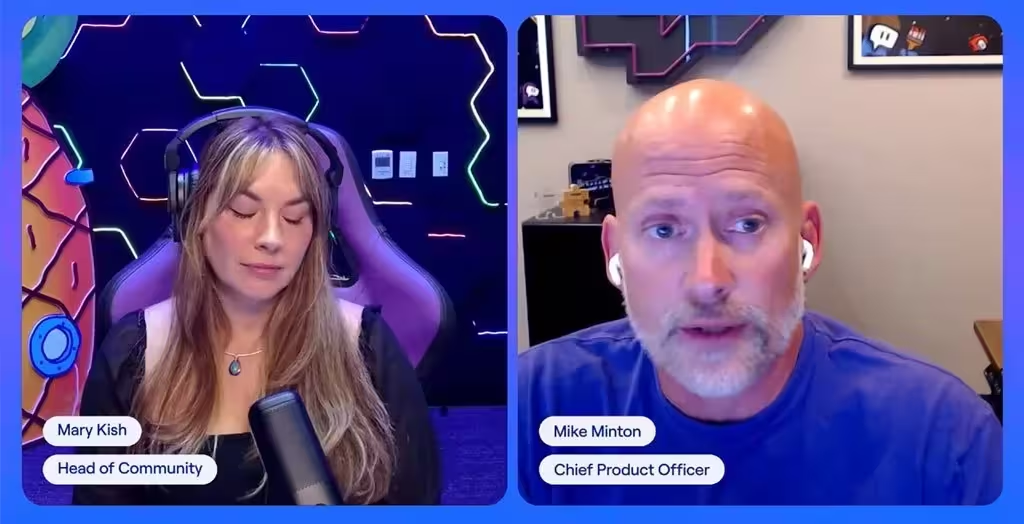
Amazon afirmă că creatorii pot renunța. Totuși, alegerea este setată implicit ca acceptare. Mulți streameri află de schimbare abia după ce trece o actualizare de politică pe ecran sau când chatul se încinge în timpul unui stream oficial al companiei. Acea explozie a avut deja loc: o transmisie recentă pe Twitch cu managerii platformei a generat mii de reacții furioase în chat, un semnal crud al cât de sensibilă este problema pentru comunitate.
Există o preocupare mai largă că aceasta nu este un caz izolat. Streamerii se întreabă dacă arhivele lor vechi au fost preluate cu mult înainte de orice anunț. Giganții tech tind să nege colectarea indiscriminată, totuși modelele lingvistice și multimodale s-au antrenat clar pe vaste porțiuni ale webului: imagini, cărți, videoclipuri; iar acum, se pare, și streamurile în direct sunt vizate.
Deci ce ar trebui să facă creatorii? Verificați-vă setările. Citiți clauzele mici. Decideți dacă doriți ca conținutul vostru să fie hrană pentru sisteme generative. Și solicitați platformelor fluxuri de consimțământ mai clare și proactive în locul unor comutatoare ascunse. Dezbaterea despre cine deține atenția online este departe de a se încheia, însă pentru oricine intră în direct întrebarea devine foarte personală.

Lasă un comentariu
Comentarii
Niciun comentariu încă. Fii primul.