Un nou studiu al Universității din Michigan arată că modelele generative de inteligență artificială consumă semnificativ mai multă energie atunci când generează text în limbi altele decât engleza — între 1,4 și 180 de ori mai mult — și pot oferi rezultate mai puțin precise în aceste limbi. Cercetătorii raportează că modelele AI folosesc între 1,4 și 180 de ori mai multă energie pentru a genera text în alte limbi.
Rezultatele și amploarea studiului
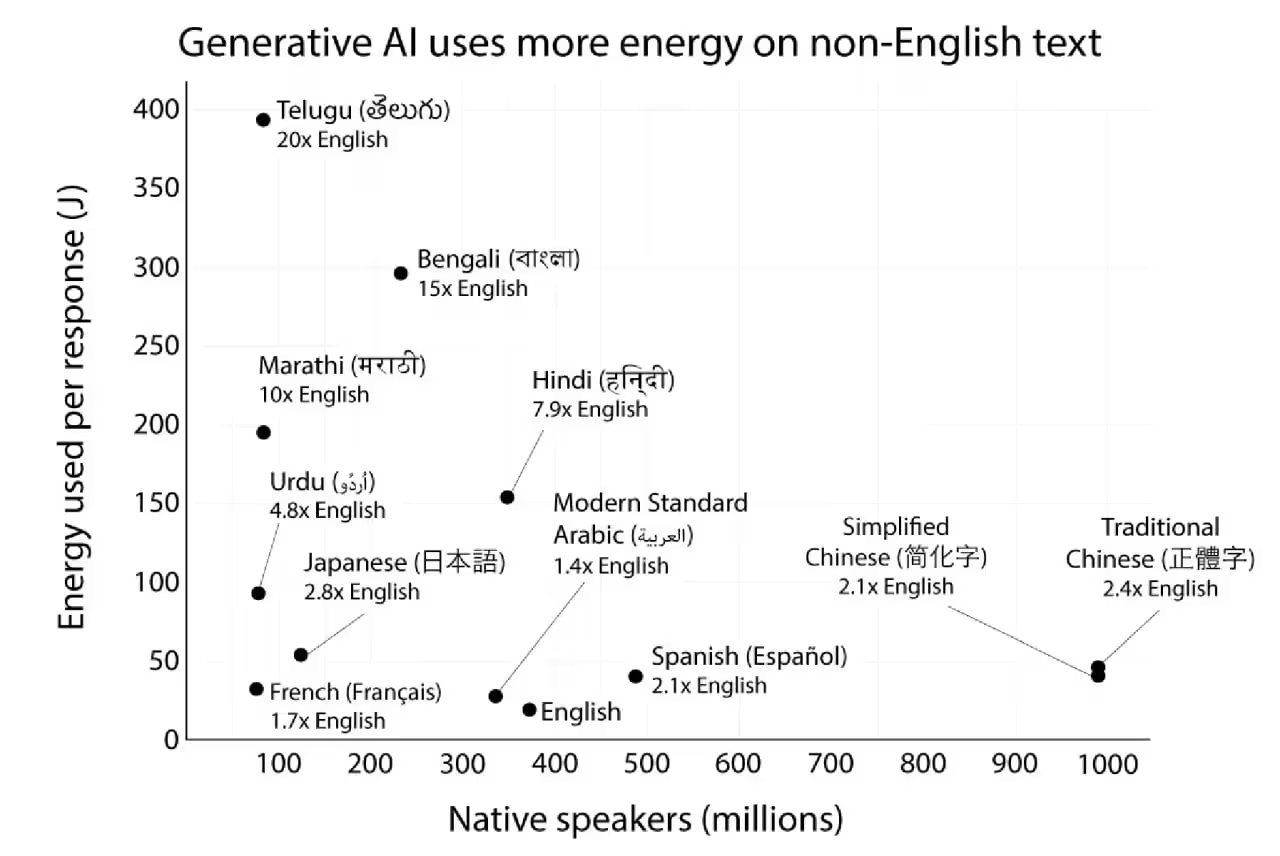
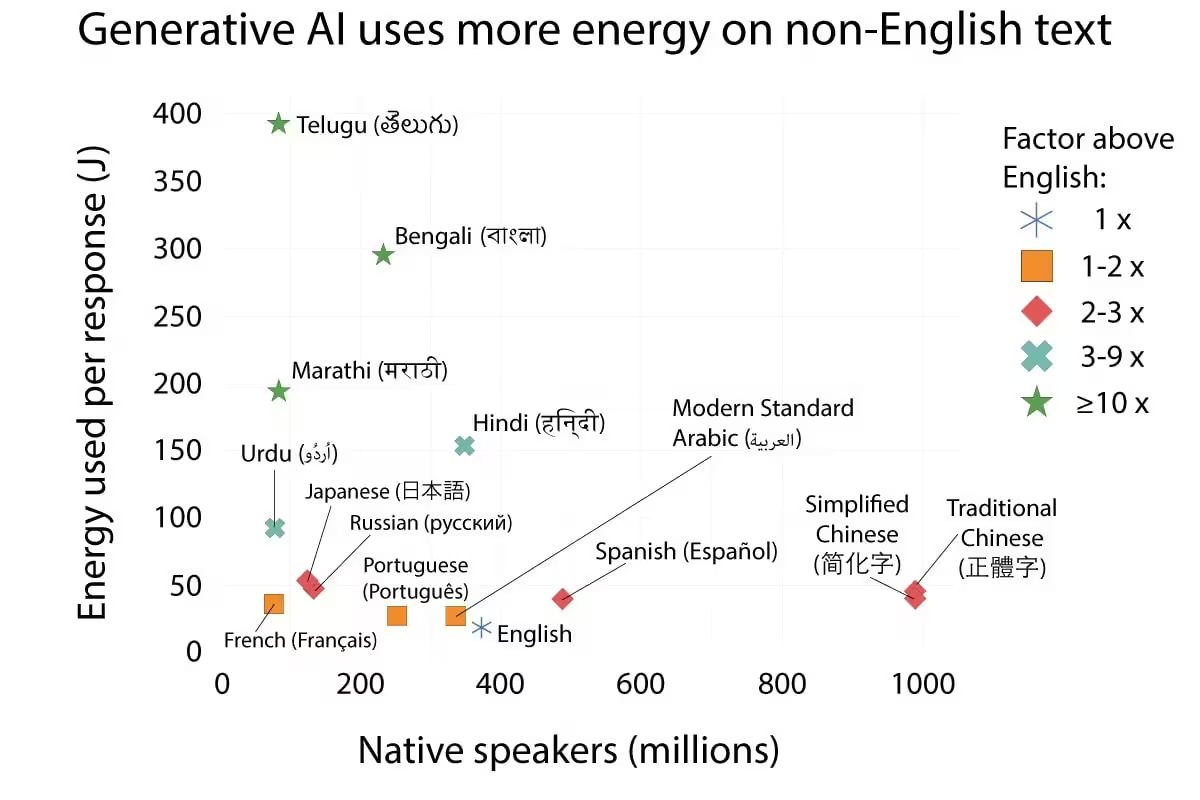
Studiul, prezentat la conferința EMNLP, a măsurat consumul de energie necesar pentru generarea de text în mai multe limbi. Cele mai mari diferențe au fost observate în limbile care nu folosesc alfabetul latin și pentru care există mai puține date digitale de antrenament. În medie, modelele au nevoie de între 1,4 și 180 de ori mai multă energie pentru a genera text în alte limbi decât în engleză. Limbile din Europa de Vest au fost, în cel mai nefavorabil scenariu, de aproximativ două ori mai costisitoare decât engleza, în timp ce hindi și bengali au necesitat de 7,9, respectiv 15,3 ori mai multă energie. Autorii estimează că, la nivel global, aproximativ 5,2 miliarde de persoane au nevoie de peste două ori mai multă energie pentru a genera text în limba maternă decât vorbitorii de engleză.
Naihao Deng, doctorand în informatică și inginerie la Universitatea din Michigan și autorul principal al lucrării, afirmă că limbile cu un consum energetic mai mare tind să aibă și o precizie mai scăzută a modelelor. El a descris fenomenul drept o „dublă penalizare”, care poate limita accesul utilizatorilor confruntați cu costuri mai mari și poate reduce stimulentele companiilor de a susține anumite limbi.
Metode, modele și măsurători
Pentru a cuantifica diferențele, echipa a evaluat trei modele deschise și le-a măsurat consumul energetic cu ajutorul unui cadru dedicat. Modelele testate au fost:
- Qwen 3 (Alibaba)
- Gemma 3 (Google)
- Llama 3.1 (Meta)
Cercetătorii au folosit setul de date Belebele, care evaluează capacitatea modelelor de înțelegere în 122 de limbi, și cadrul de măsurare ML.Energy. Au rulat întrebări cu alegere multiplă, probleme de matematică și solicitări cu răspuns liber. Rezultatele au arătat că toate cele trei modele au consumat, în medie, mai puțină energie pentru prompturile în engleză, iar diferențele s-au păstrat inclusiv în cazul modelelor mai mari și al procesoarelor diferite.
Cauze și explicația tehnică
Principala explicație tehnică este tokenizarea. Tokenii sunt unitățile de bază de date procesate de modele, iar textul este convertit în tokeni înainte de calcul. Limbi precum hindi și nepaleza, în care caracterele își schimbă forma sau se combină cu semne diacritice, generează mult mai mulți tokeni pentru același conținut semantic. Generarea unui număr mai mare de tokeni crește utilizarea memoriei, obligând modelele să proceseze tokenii în loturi mai mici. Loturile mai mici sporesc energia consumată per token și reduc rata de procesare. Întrucât mulți furnizori taxează accesul în funcție de numărul de tokeni, utilizatorii limbilor non-latine se pot confrunta și cu costuri directe mai mari.
Implicații și soluții propuse
Studiul evidențiază o potențială sursă de inegalitate digitală la nivel global: utilizatorii multor limbi non-latine și cu resurse reduse pot plăti mai mult, atât în energie, cât și în bani, și pot primi rezultate de calitate mai slabă. Pentru a corecta acest dezechilibru, cercetătorii recomandă companiilor de AI să își optimizeze serviciile pentru o gamă mai largă de limbi, de exemplu prin direcționarea interogărilor către modele specifice fiecărei limbi sau, atunci când este cazul, prin traducerea prompturilor în engleză înainte de procesare.

Lasă un comentariu
Comentarii
Niciun comentariu încă. Fii primul.